2026-10-29
照片生成 AI 影片:完整指南
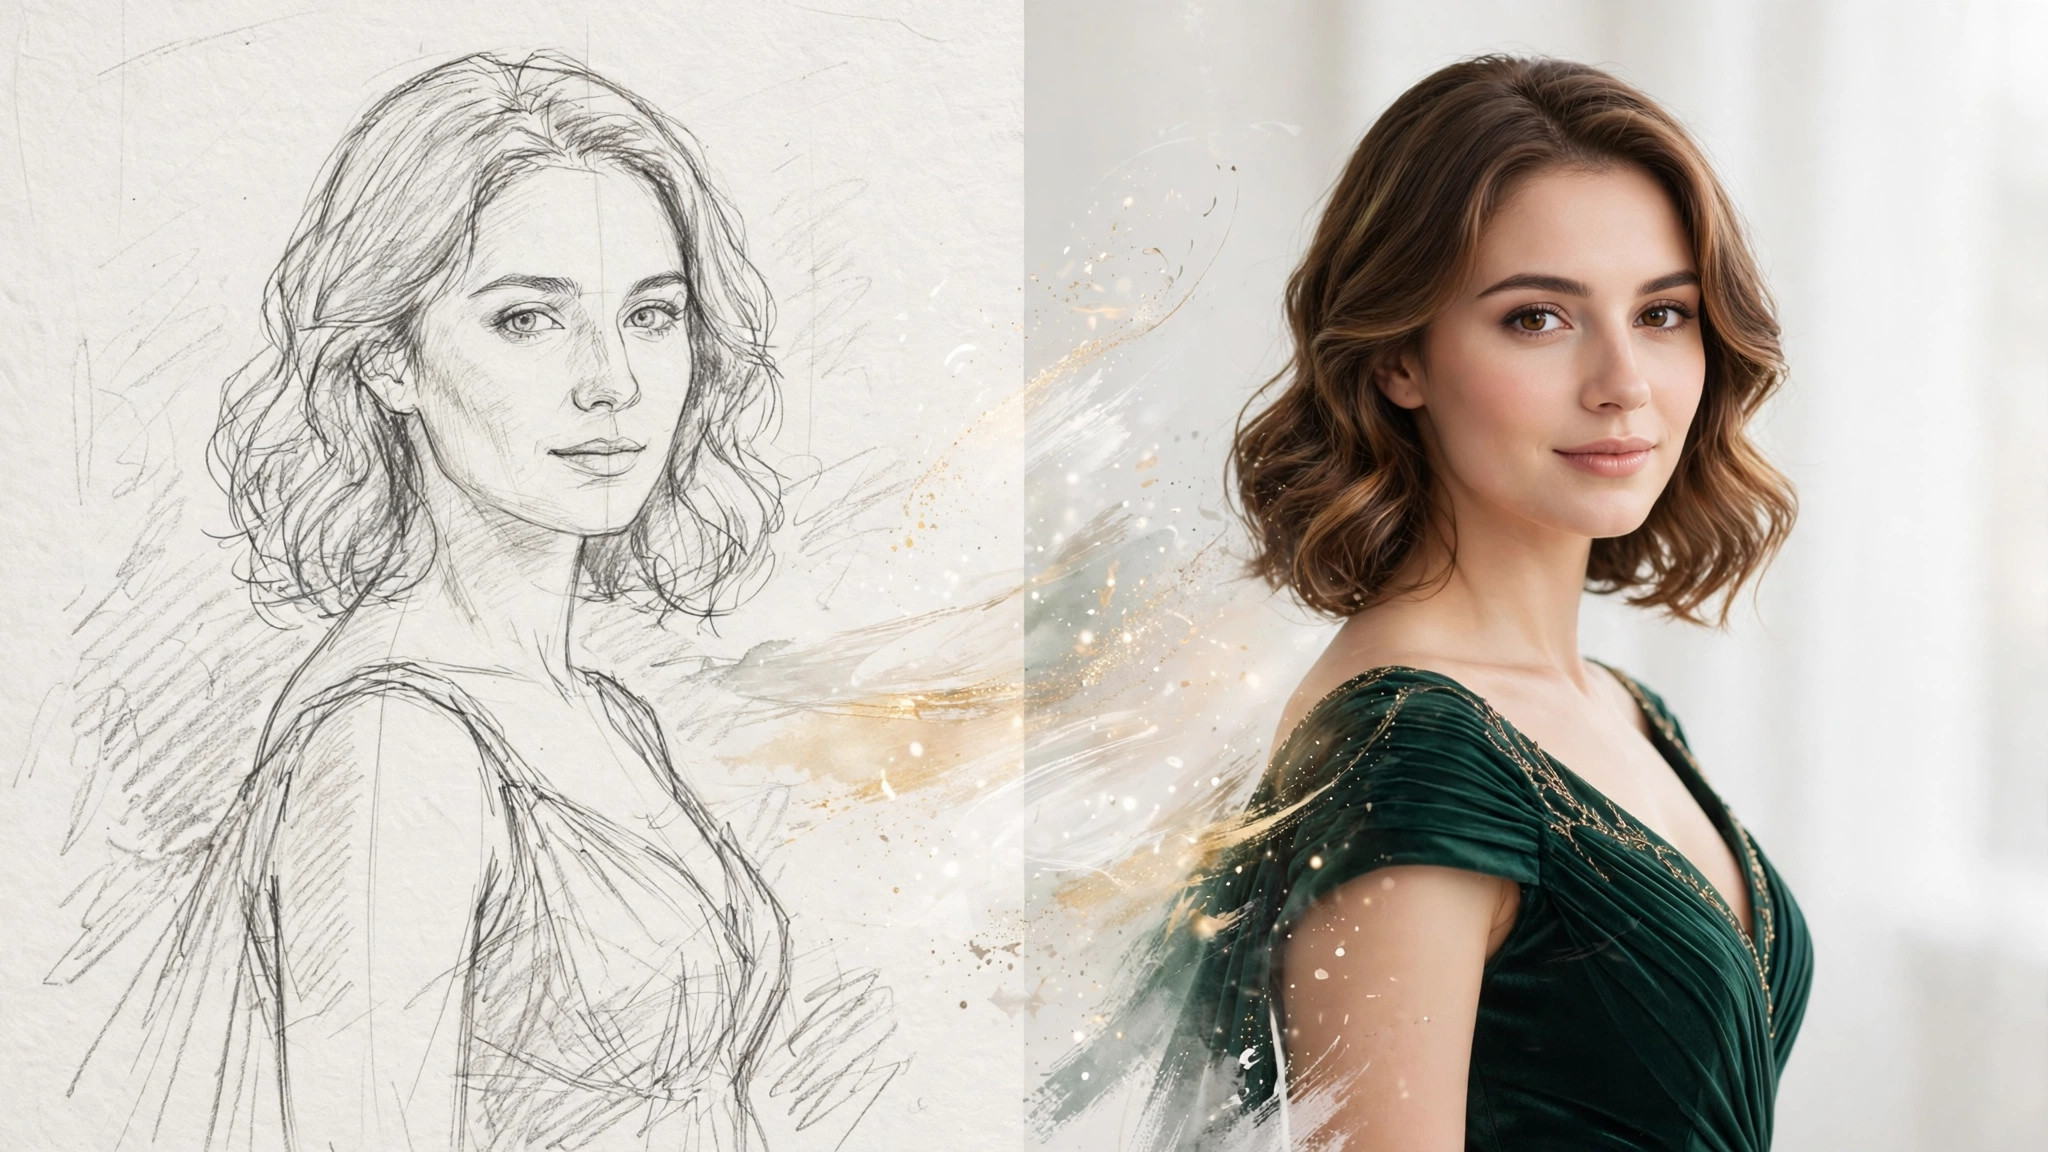
photo-to-video 的實際運作原理
image-to-video 是進入 AI 影片生成最實用的入口。你不需要從零開始描述整個場景,只要給模型一張照片,讓它想像接下來幾秒會發生什麼。照片鎖定了構圖、主體、光線和風格;模型唯一的工作就是動。這個限制正是為什麼在同等技術水準下,photo-to-video 的效果會比 text-to-video 好這麼多。
在底層,模型做兩件事。第一,像圖像模型一樣分析你的照片:主體、景深、光線、質感。第二,根據你的動作提示詞,預測接下來一小段合理的連續畫面。輸出品質取決於三個輸入,大致按重要性排序:來源照片、動作描述,和生成設定。大多數疑難排解指南從設定講起;這篇從照片講起,因為大多數失敗都是從這裡開始的。
先講清楚一個期望:模型動畫化的是照片裡有的東西,不會重新想像。如果照片又暗又糊、構圖又差,影片就會是又暗又糊、構圖又差的會動版。進垃圾,出垃圾動畫。
挑對照片:八成法則
解析度很重要,但不是大家想的那種重要法。你不需要 4K 素材;大多數影片模型內部都是用 720p 運作,無論如何都會把你的輸入縮小。你需要的是一張乾淨、清晰、尺寸合理的照片——長邊 1024 像素就非常夠了。一張清晰的 1024px 照片,每次都打敗一張模糊的 4K 照片。
構圖才是真正的關鍵。模型只能動畫化它看得到的東西,所以主體要完整入鏡,周圍留一點呼吸空間。太緊的裁切切掉手腳或頭頂,會逼模型在動態中發明那些不見了的身體部位——這是解剖學 glitch 的主因。想要特寫影片,就拍一張特寫照片;不要指望模型幫你重新構圖。
臉有特別的規則。正面或四分之三側面、光線均勻、沒有遮擋的臉,保留身份的效果遠勝側臉、深色陰影,或被頭髮、手半遮住的臉。模型是靠比對所見來跨畫面追蹤臉部特徵;給它一個清晰的參考,漂移就會大幅下降。
來源照片的光線決定了影片的上限。均勻柔和的光能給模型關於形狀和質感的乾淨資訊。來源照片裡的強烈對比、重濾鏡或極端調色,在動態中會被放大,不會被磨平。不確定就選手邊光線最自然的那個版本。
重要設定:片長、比例、動作
片長是第一個要決定的設定,學習階段短一點比較聰明。五秒是標準測試長度:夠長可以判斷動作看起來自不自然,又夠短讓反覆嘗試的成本很低。五秒版穩定了再延長到八秒或十秒,因為較長的生成會同時倍增成本和片中劣化的機率。
長寬比要跟來源照片,而不是跟目標平台。如果照片是直式 9:16,你卻要求 16:9 影片,模型就得裁切或拉伸,兩種都會傷品質。先把比例對齊照片;給平台用的重新構圖之後再用標準剪輯工具做。
動作強度(有時叫 motion intensity 或 dynamics)控制動得有多劇烈。數值低會產生微妙、接近靜態畫面的效果——穩但無聊。數值高會產生戲劇性的動作——刺激但容易 warping 和身份漂移。從中間開始,看效果再調整:影片感覺凍結了就調高;臉開始融化就調低。
種子值和固定設定在影片比在圖像更重要。找到可行的組合之後,在調整提示詞之前先鎖定種子值。在種子值漂移的同時改動作描述,你永遠學不到哪個改動帶來哪個效果——跟靜態圖提示詞反覆嘗試一樣的單變量紀律。
動作提示詞:用動詞,不用名詞
動作提示詞是另一種技能,跟圖像提示詞不同。圖像提示詞描述靜態場景,動作提示詞描述時間中的變化。模型需要的是動詞、方向和節奏——不只是名詞。
從主要動作開始。「她慢慢把頭轉向鏡頭」勝過「beautiful woman, cinematic」,因為它告訴模型實際在動的是什麼。一個清晰的主要動作勝過三個互相打架的;什麼都在動,就什麼都不像刻意的。
加一點次要動作來增加真實感。頭髮輕輕飄動、布料晃動、背景元素漂移——這些細微的次要動作正是「會動的照片」和「影片」的差別。簡單描述就好:「她的頭髮在微風中輕輕飄動」就夠了。物理的部分模型自己會補。
指明哪些要保持靜止。「鏡頭固定」或「locked-off shot」可以防止模型擅自加上那種令人作嘔的慢速 zoom。如果你想要鏡頭運動,就明確說(「slow push-in」),不要讓模型即興發揮。
動作提示詞要短——兩到三句。太長太華麗的動作描述會稀釋核心指令,跟過長的圖像提示詞一樣。主體、主要動作、次要動作、鏡頭行為。這就是整條公式。
常見失敗與修正方法
身份漂移——臉在畫面之間變了——是最多人回報的失敗。原因按順序:來源照片的臉不清楚、動作強度太高、片長太長。按這個順序修:先換一張好一點的來源照片,再降低動作,再縮短影片。不要想只靠提示詞的文字去修漂移;這是資料問題,不是語言問題。
凍結或接近靜止的輸出,通常代表動作提示詞太弱或動作強度太低。兩個一起加強再重新生成。如果模型還是幾乎不動,可能是來源照片缺少景深線索(太平的光、單調的背景給不了模型什麼發揮空間)。
warping 和融化——手腳彎到不可能的角度、背景糊開——是因為動作強度高過場景撐得住的程度。複雜姿勢和繁忙背景撐得住的動作比簡單場景少。降低強度或簡化:挑一張平靜一點的來源照片。
閃爍和質感爬行最常出現在長片,而且通常從生成中段開始。實際的解法是縮短片長;十秒會閃的片,五秒版通常乾乾淨淨。把片長當作品質控制,不只是創作選擇。
解剖學 glitch(動態中途冒出多餘的手指、轉頭時臉變形)是靜態圖「手部問題」的影片版——因為模型要跨畫面維持解剖學,所以被放大了。來源照片構圖留多一點空間、避開極端姿勢、動作保持適中,就能降到最低。現行技術本身就有一定的 glitch 率;預留一點預算重新生成。
起飛前檢查清單(省下你的 credits)
每次生成之前,先跑一遍這個檢查清單。來源照片:清晰、光線好、主體完整入鏡,身份重要的話臉要清楚。長寬比:跟照片一致。片長:測試用五秒。動作強度:從中間開始。動作提示詞:一個主要動作、一個次要動作、指明鏡頭行為。種子值:找到喜歡的設定就鎖定。
生成之後按這個順序評估。第一,身份:主體還像不像照片?不像就先修來源照片或降低動作,不要碰別的。第二,動作品質:動作看起來物理上合不合理?第三,瑕疵:整支影片掃一遍 warping、閃爍或解剖學問題,尤其劣化最集中的最後兩秒。
記個簡單的 log:用過哪張照片、什麼設定、什麼動作提示詞、什麼種子值,和一行結論。生成二十次之後你就有自己的 playbook——人像和全身照分別用什麼動作強度、你的相機拍的照片哪些最適合動畫化、你平台的模型怎麼處理頭髮和布料。這本 playbook 比任何指南都有價值,因為它是為你的輸入調校的。
還有那條 meta 規則:便宜地反覆嘗試。五秒、低成本、快速 turnaround 地測試。便宜版證明了概念,再花長而貴的生成。AI 影片浪費最多 credits 的,就是那些沒試過的想法的十秒片。