2026-10-29
AI-video fra foto: Den komplette guide
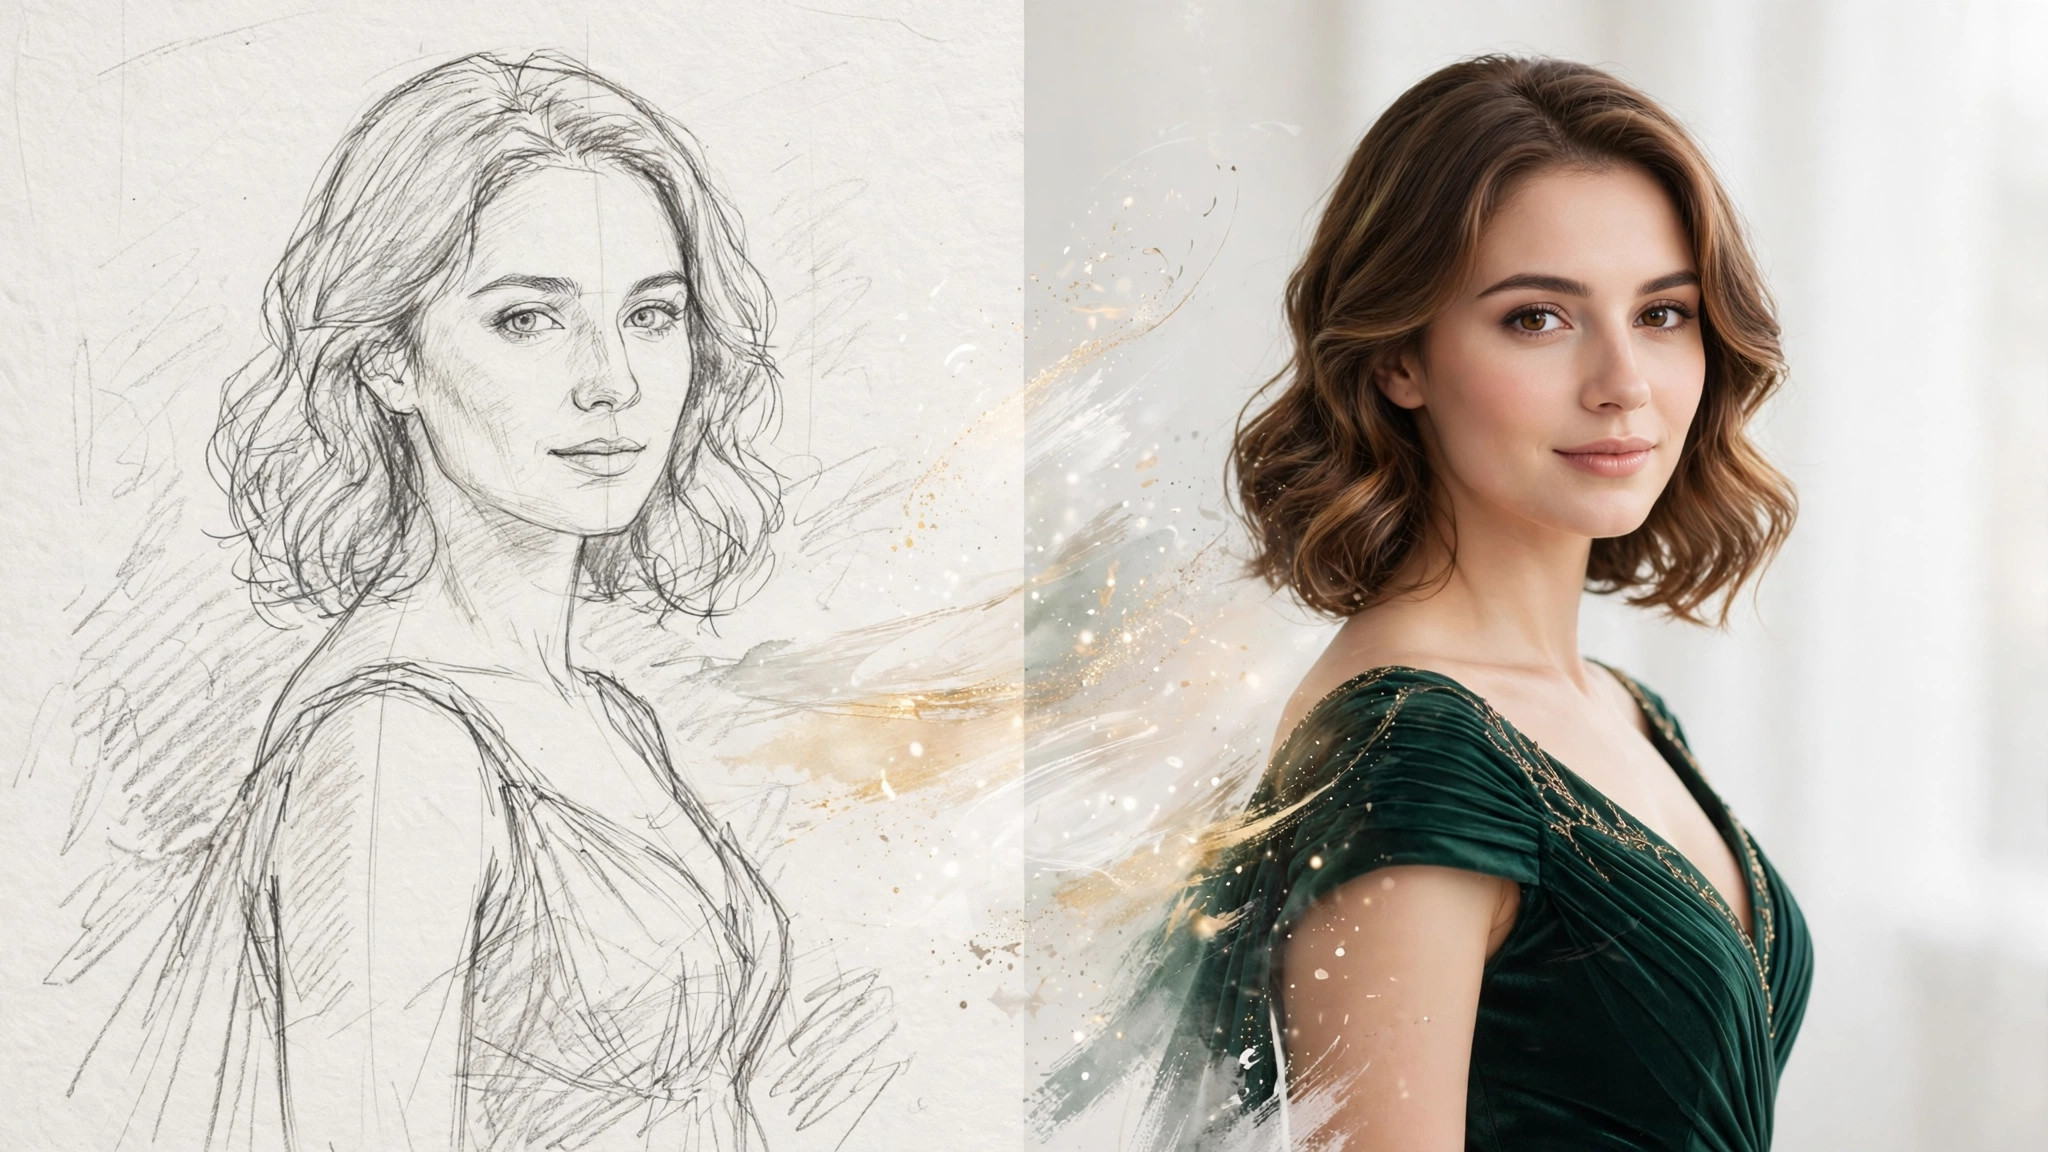
Sådan fungerer photo-to-video i virkeligheden
Image-to-video er den mest praktiske indgang til AI-videogenerering. I stedet for at beskrive en hel scene fra bunden giver du modellen et fotografi og beder den forestille sig de næste par sekunder. Fotoet låser komposition, motiv, lys og stil; modellens eneste job er bevægelse. Den begrænsning er grunden til, at photo-to-video-resultater ser dramatisk bedre ud end text-to-video på samme teknologiniveau.
Under hjelmen gør modellen to ting. Først analyserer den dit billede, som en billedmodel ville gøre: motiver, dybde, lys, teksturer. Dernæst forudsiger den en kort sekvens af frames, der plausibelt følger efter, styret af din motion-prompt. Outputkvaliteten afhænger af tre inputs, groft i denne vigtighedsrækkefølge: kildefotoet, bevægelsesbeskrivelsen og genereringsindstillingerne. De fleste fejlfindingsguides starter med indstillingerne; denne starter med fotoet, for det er her, de fleste fejl opstår.
Én forventning at få på plads tidligt: modellen animerer det, der er på fotoet. Den genopfinder det ikke. Hvis dit foto er mørkt, uskarpt eller akavet beskåret, bliver videoen en bevægelig version af mørkt, uskarpt og akavet beskåret. Skrald ind, bevægelse ud.
Vælg det rigtige foto: 80-procent-reglen
Opløsning betyder noget, men ikke på den måde, folk tror. Du har ikke brug for en 4K-kilde; de fleste videomodeller arbejder internt i 720p og nedskalerer dit input alligevel. Det, du har brug for, er et rent, skarpt billede i rimelig størrelse — 1024 pixels på den lange led er rigeligt. Et skarpt 1024px-foto slår et uskarpt 4K-foto hver gang.
Beskæringen er den reelle løftestang. Modellen kan kun animere det, den kan se, så motiver skal være helt i billedet med luft omkring sig. Stramme crops, der skærer lemmer eller toppen af hovedet af, tvinger modellen til at opfinde manglende kropsdele i bevægelse — en hovedårsag til anatomiske glitches. Vil du have en close-up-video, så tag et close-up-foto; forvent ikke, at modellen beskærer for dig.
Ansigter fortjener særlige regler. Et frontalt eller trekvart ansigt, jævnt belyst og uhindret, bevarer identiteten dramatisk bedre end en profil, et ansigt i dyb skygge eller et, der er delvist dækket af hår eller hænder. Modellen sporer ansigtstræk på tværs af frames ved at matche det, den ser; giv den en klar reference, og driften falder markant.
Lyset i kildefotoet sætter loftet for videoen. Jævnt, blødt lys giver modellen rene informationer om former og teksturer. Hård kontrast, tunge filtre eller ekstrem farvegraduering i kilden forstærkes i bevægelse, ikke udjævnes. I tvivl: vælg den mest naturligt belyste version af det billede, du har.
Indstillinger, der betyder noget: varighed, format, bevægelse
Varighed er den første indstilling, du skal beslutte, og kortere er klogere, mens du lærer. Fem sekunder er standardtestlængden: langt nok til at vurdere, om bevægelsen ser naturlig ud, kort nok til at holde iteration billig. Udvid først til otte eller ti sekunder, når femsekundersversionen er solid, for længere genereringer ganger både omkostning og chancen for kvalitetsforringelse midt i klippet.
Billedformatet skal matche dit kildefoto, ikke din målplatform. Hvis dit foto er portræt 9:16, og du beder om 16:9-video, må modellen beskære eller strække — begge dele skader kvaliteten. Match først formatet til fotoet; beskær til platforme bagefter med standardredigeringsværktøjer.
Motion strength (kaldes sommetider motion intensity eller dynamics) styrer, hvor meget der bevæger sig. Lave værdier giver subtile, næsten stillestående resultater — sikkert, men kedeligt. Høje værdier giver dramatisk bevægelse — spændende, men udsat for warping og identity drift. Start i midten, og justér ud fra det, du ser: føles videoen frossen, så skru op; begynder ansigter at smelte, så skru ned.
Seed og faste indstillinger betyder mere for video end for billeder. Når du finder en kombination, der virker, så lås seedet, før du itererer på prompten. At ændre bevægelsesbeskrivelsen, mens seedet driver, betyder, at du aldrig lærer, hvilken ændring der gav hvilken effekt — den samme én-variabel-disciplin som prompt-iteration for stills.
Prompting af bevægelse: verber, ikke substantiver
Motion-prompten er en anden færdighed end image-prompting. Hvor en billedprompt beskriver en statisk scene, beskriver en motion-prompt forandring over tid. Modellen har brug for verber, retninger og tempo — ikke kun substantiver.
Start med den primære bevægelse. “Hun drejer langsomt hovedet mod kameraet” slår “beautiful woman, cinematic”, fordi den fortæller modellen, hvad der faktisk bevæger sig. Én klar primærbevægelse slår tre konkurrerende; hvis alt bevæger sig, læses intet som intentionelt.
Tilføj sekundær bevægelse for realisme. Hår, der svajer let, stof, der skifter, baggrundselementer, der driver — disse små sekundære bevægelser adskiller “animeret foto” fra “video”. Beskriv dem kort: “hendes hår bevæger sig blidt i brisen” er nok. Modellen udfylder fysikken.
Specificér, hvad der skal forblive stille. “Kameraet forbliver statisk” eller “locked-off shot” forhindrer den kvalmende langsomme zoom, modellen nogle gange tilføjer uopfordret. Vil du have kamerabevægelse, så navngiv den eksplicit (“slow push-in”) i stedet for at lade modellen improvisere.
Hold motion-prompts korte — to til tre sætninger. Lange, udsmykkede bevægelsesbeskrivelser fortynder kerneinstruktionen, ligesom for lange billedprompts gør. Motiv, primær bevægelse, sekundær bevægelse, kameraadfærd. Det er hele formlen.
Almindelige fejl og hvordan du fikser dem
Identity drift — ansigtet ændrer sig på tværs af frames — er den mest rapporterede fejl. Årsager i rækkefølge: uklart ansigt i kildefotoet, for høj motion strength og for lang varighed. Fiks i den rækkefølge: først et bedre kildefoto, sænk så bevægelsen, forkort så klippet. Forsøg ikke at fikse drift med prompt-ord alene; det er et dataproblem, ikke et sprogproblem.
Frosset eller næsten statisk output betyder som regel, at motion-prompten var for svag, eller at motion strength var for lav. Styrk begge, og generér igen. Hvis modellen stadig næsten ikke bevæger sig, mangler kildefotoet måske dybdespor (meget fladt lys, enkle baggrunde giver modellen lidt at arbejde med).
Warping og smeltning — lemmer, der bøjer umuligt, baggrunde, der smører ud — kommer fra motion strength sat for højt i forhold til, hvad scenen bærer. Komplekse positurer og travle baggrunde tåler mindre bevægelse end enkle. Sænk styrken, eller forenkl: vælg et roligere kildefoto.
Flimmer og teksturkrybning sker mest i længere klip og starter som regel midt i genereringen. Den praktiske løsning er kortere varighed; femsekundersversionen af et klip, der flimrer ved ti sekunder, er ofte helt ren. Behandl varighed som kvalitetskontrol, ikke kun som et kreativt valg.
Anatomi-glitches (ekstra fingre, der dukker op midt i bevægelsen, ansigter, der forvrænges ved drejninger) er videoækvivalenten til stills-håndproblemet — forstærket, fordi modellen skal holde anatomien på tværs af frames. Minimér ved at holde kildebeskæringen generøs, undgå ekstreme positurer og holde bevægelsen moderat. En vis glitch-rate er iboende i den nuværende teknologi; budgettér med re-rolls.
Pre-flight-tjeklisten (spar dine credits)
Før hver generering: gennemgå denne tjekliste. Kildefoto: skarpt, velbelyst, motivet helt i billedet, ansigtet tydeligt, hvis identitet betyder noget. Billedformat: matcher fotoet. Varighed: fem sekunder til test. Motion strength: midten til at starte. Motion-prompt: én primær bevægelse, én sekundær, kameraadfærd specificeret. Seed: låst, når du finder indstillinger, du kan lide.
Efter generering: evaluér i denne rækkefølge. Først identitet: ligner motivet stadig fotoet? Hvis ikke, så fiks kilden eller sænk bevægelsen, før du rører andet. Dernæst bevægelseskvalitet: ser bevægelsen fysisk plausibel ud? For det tredje artefakter: scan hele klippet for warping, flimmer eller anatomibrud, især i de sidste to sekunder, hvor forringelsen koncentreres.
Før en simpel log: brugt foto, indstillinger, motion-prompt, seed og en én-linjes dom. Efter tyve genereringer har du din egen playbook — hvilke motion strengths der virker til portrætter versus helfigursbilleder, hvilke af dine kameraers fotoer der animerer bedst, hvordan din platforms model håndterer hår og stof. Den playbook er mere værd end nogen guide, fordi den er tunet til dine inputs.
Og meta-reglen: iterér billigt. Test ved fem sekunder, lave omkostninger, hurtig turnaround. Brug først den lange, dyre generering, når den billige version har bevist konceptet. De fleste spildte credits i AI-video kommer fra tisekundersklip af utestede idéer.